Lokale KI auf eigener Hardware laufen zu lassen, erscheint verlockend: Du hast keine Datenschutzprobleme, niemand kann dir dein Modell abschalten und kostenlos ist der Betrieb auch noch. Und in der Tat ist lokale KI-Nutzung ein riesiger Sprung in den Möglichkeiten, die uns Computer heute anbieten. Doch der Einstieg kann manchmal komplex und abschreckendwirken. Mit dieser Anleitung sollte es aber ganz einfach gelingen.
Der lokale KI-Stack
Was wir zum Einstieg benötigen, sind drei Dinge:
- Eine Inferenz-Software, die das KI-Modell lädt, Anfragen entgegen nimmt und die Antwort zurückgibt
- Das Sprachmodell: Eine Datei, die die Parameter des KI-Modells enthält
- Einen Client für den bequemen Zugriff auf die Inferenz-Software
Inferenz-Software
Starten wir zunächst mit der Software, die uns die eigentliche KI-Funktion bereit stellt. Hier haben sich derzeit drei Kommandozeilen-Tools als besonders geeignet herauskristallisiert:
| Software | Lizenz | Dateiformat |
|---|---|---|
| llama.cpp (öffnet in neuem Tab) | MIT | GGUF |
| vLLM (öffnet in neuem Tab) | Apache 2.0 | Safetensors |
| ollama (öffnet in neuem Tab) | MIT | GGUF |
Stand September 2026 ist llama.cpp vermutlich die Software, die für lokale KI am meisten eingesetzt wird. Sie bringt Unmengen an Features und Einstellmöglichkeiten und erlaubt so, die vorhandene Hardware bestmöglich auszureizen. vLLM ist vor allem für den produktiven Einsatz interessant, wenn viele Nutzer gleichzeitig auf ein LLM zugreifen sollen. ollama hingegen ist eine einfacher zu bedienende Variante von llama.cpp, mit der man sehr einfach starten kann, die aber deutlich weniger Anpassungen erlaubt.
LLM-Clients
So wie wir für die große KI die Apps von ChatGPT, Gemini oder Claude nutzen, benötigen wir auch für unsere lokale KI eine Anwendung, die uns erlaubt, mit dem Modell zu kommunizieren. Die Auswahl an Clients ist inzwischen komplett unübersichtlich geworden, hier sind einige Empfehlungen:
| Client | Lizenz | Anmerkung |
|---|---|---|
| Jan Desktop (öffnet in neuem Tab) | Apache 2.0 | Desktop-App, erhältlich für Windows, Mac und Linux |
| Open WebUI (öffnet in neuem Tab) | modifizierte BSD-Lizenz | Webanwendung, Setup mit Docker oder Python Environments |
| LM Studio (öffnet in neuem Tab) | propreitär | Desktop-App mit kommerzieller Lizenz |
| AnythingLLM (öffnet in neuem Tab) | MIT | Desktop-App, aber auch angepasste Server-Setups möglich |
Mein aktueller Favorit ist Jan. Es ist übersichtlich und bringt doch die wichtigsten Funktionen mit, um lokale Modelle ausführlich testen zu können. Viele dieser Clients haben auch gleich eine eingebaute Inferenz-Software. Das erspart eine eigenständige Installation dieser Software, macht das Setup aber abhängig vom jeweiligen Client. Wir verlieren damit die Kontrolle über unseren Tech-Stack, weshalb ich jedem, der etwas intensiver einsteigen möchte, rate, beide Aufgaben – Inferenz und Client – voneinander getrennt zu halten. Für den ersten schnellen Einstieg in die Welt der lokalen KI aber ist so ein Kombi-Client aber durchaus hilfreich.
Um es noch komplizierter zu machen, bringt auch manche Inferenz-Software einen integrierten Client mit. So hat llama.cpp etwa inzwischen eine Web-Oberfläche eingebaut. Für erste schnelle Tests ist damit ein eigener Client nicht mehr unbedingt nötig.
Sprachmodell
Das eigentliche LLM ist eine Datei mit Milliarden an Parametern, in denen alles, was das Modell gelernt hat, gespeichert ist. Die Größe des Modells ist entscheidend für seine Leistungsfähigkeit. Im Prinzip gilt: Je größer, desto besser. Dummerweise wächst mit der Modellgröße auch die Anforderung an die Hardware. Ein großer Teil der Planung und des Betriebs lokaler KI beschäftigt sich deshalb damit, den richtigen Kompromiss zwischen Hardware und Leistungsfähigkeit zu finden.
In der Tabelle sind die wichtigsten Eigenschaften eines Sprachmodells zusammengefasst:
| Eigenschaft | Beschreibung |
|---|---|
| Parameter | Die Parameter (auch Modellgewichte genannt) beinhalten die eigentliche Intelligenz eines LLM. Jeder Parameter umfasst dabei typischerweise eine 16-Bit-Fließkommazahl. Die Anzahl der Parameter wird in Modelldateien meist als Zahl gefolgt von einem “b” für “billion” (deutsch: Milliarden) angegeben: Die Bezeichnung Gemma 4 12b sagt uns also, dass dieses Modell 12 Milliarden Parameter umfasst. |
| Quantisierung | Ähnlich wie Bilder als JPG mit gewissen Qualitätsverlusten komprimiert werden können, lassen sich auch LLM komprimieren. Dieser Prozess heißt Quantisierung. Eine Quantisierung auf 4 Bit pro Parameter hat sich für lokale KI als De-Facto-Standard etabliert. Die Quantisierung eines Modell wird in seinem Namen häufig mit einem vorangestellten “Q” genannt. Qwen3.5-9B-Q4 steht somit für 9 Milliarden Parameter, die mit 4-Bit-Quantisierung gespeichert wurden. |
| Architektur | Die meisten Modelle bearbeiten in jedem Rechenschritt alle Parameter, diese werden als “dense models” bezeichnet. Im Gegensatz dazu stehen die “mixture of experts” (MoE) Modelle, die immer nur einen kleinen Teil der gesamten Parameter aktivieren. MoE-Modelle sind damit für lokale KI-Nutzung besonders geeignet, da sie bei beschränktem VRAM schneller arbeiten als ähnlich große “dense” Modelle. Der Geschwindigkeitszuwachs wird aber durch eine etwas geringere Leistungsfähigkeit erkauft. |
| Spezialisierung | Nach dem eigentlichen Training werden viele Modelle noch einmal für einen bestimmten Einsatzzweck feinabgestimmt (englisch: fine-tuning). So gibt es Allzweck-Modelle für den allgemeinen Chat-Gebrauch, während andere gezielt auf Programmieren, auf Werkzeugnutzung (“Tool-Calling”) oder auf mathematisches Denken trainiert wurden. Diese Spezialisierung erkennt man oft am Namenszusatz: Qwen3-Coder-Next etwa ist auf Programmieraufgaben optimiert, während ein Zusatz wie -Instruct auf ein für Dialoge und Befehlsbefolgung feinabgestimmtes Modell hinweist. |
Für die großen Modelle der bekannten KI-Anbieter sind leider viele Details unbekannt. Es gibt Schätzungen zur Parameterzahl, die in der Tabelle unten zusammengestellt sind. Über die Architektur oder zum Fine-Tuning gibt es keine sinnvollen Informationen.
| Modell | Parameter (in Mrd.) | Anbieter | Quelle |
|---|---|---|---|
| GPT-3 | 175 | OpenAI | arxiv.org (öffnet in neuem Tab) |
| GPT-4o | 200 | OpenAI | epoch.ai (öffnet in neuem Tab) |
| GPT-4 | 1800 | OpenAI | epoch.ai (öffnet in neuem Tab) |
| GPT-5.2 | 1800 | OpenAI | medium.com (öffnet in neuem Tab) |
| Sonnet 3.5 | 400 | Anthropic | epoch.ai (öffnet in neuem Tab) |
| Claude 3 | 2000 | Anthropic | medium.com (öffnet in neuem Tab) |
Zum Vergleich: Leistungsfähige lokale Modelle, die auf typischer Consumer-Hardware mit Gaming-Grafikkarten akzeptabel laufen, haben zwischen 9 und 40 Milliarden Parameter.
Zwei empfehlenswerte Modell-Familien sind Qwen 3.x (Anbieter: Alibaba) und Gemma 4 (Anbieter: Google). Während die Qwen-Modelle besonders gut geeignet sind für Programmieraufgaben und die Nutzung von Werkzeugen (Tool-Calling), haben die Gemma-Modelle ihre Stärken beim Schreiben von Texten.
| Modell | Parameter | Architektur | VRAM / RAM |
|---|---|---|---|
| Qwen3.8-27b | 27 Mrd. | dense | 24 GB |
| Qwen3.6-35b-a3b | 35 Mrd. | MoE | 6 GB / 24 GB |
| Qwen3.5-9b | 9 Mrd. | dense | 6 GB |
| Gemma4-12b | 12 Mrd. | dense | 12 GB |
| Gemma4-26B-a4b | 26 Mrd. | MoE | 6 GB / 24 GB |
| Gemma4-31B | 31 Mrd. | dense | 24 GB |
In den letzten Monaten sind viele große offene Modelle veröffentlicht worden, die die Grenze zwischen “lokaler KI” und “Frontier-Modellen” hinsichtlich der Leistungsfähigkeit immer weiter verschwimmen lassen. Da die Hardware-Ansprüche dafür aber enorm sind, stehen diese Modelle hier nicht im Fokus. Wer interessiert ist und die passende Hardware hat, hier einige interessante Modelle zum Ausprobieren:
Qwen3.8-Flash-Next: MoE, 125 Mrd. Parameter (6 Mrd. aktiv), 16 GB VRAM, 96 GB RAMGLM-5.3-Flash: MoE, 320 Mrd. Parameter (18 Mrd. aktiv), 32 GB VRAM, 192 GB RAM
Wer sich stärker mit der Flut an lokalen KI-Modellen beschäftigen möchte, dem sei die Website unsloth.ai (öffnet in neuem Tab) empfohlen.
Alle Angaben zum benötigten VRAM bzw. RAM sind nur sehr grobe Erfahrungswerte; angenommen wurde jeweils eine Q4-Quantisierung. Während es für “dense” Modelle wichtig ist, das ganze Modell im VRAM der Grafikkarte zu behalten, reicht es für MoE-Modelle aus, nur die aktiven Parameter ins VRAM zu laden und den Rest der Modelldatei im normalen System-RAM zu haben.
KI ist mehr als nur das LLM
Angesichts der Parameterzahlen könnte man leicht glauben, dass lokale KI meilenweit von den großen Cloud-KI-Systemen entfernt ist. Allerdings sind in den letzten Monaten die Modelle bei gleichbleibender Größe immer besser geworden. Außerdem ist KI viel mehr als nur das Sprachmodell. Zwar ist das LLM das Herzstück von ChatGPT oder Claude, doch es wird von einem ganzen Ökosystem an Tools ergänzt. WebSearch und WebFetch etwa erlauben dem System Zugriff auf Web-Suchergebnisse und auf Websites. Etwas, was einem nackten LLM auf unserem Rechner fehlt. Und so wirken die lokal verfügbaren LLM schnell „dümmer” als sie eigentlich sind.
Lokale KI ist deshalb viel mehr als nur ein LLM auf einem PC laufen zu lassen. Die Tools, die das Modell unterstützen und die Agentic Frameworks, die Zugriff auf MCP-Server oder gar auf lokale Dateien ermöglichen, sind mindestens genau so wichtig.
Insbesondere die Rolle des Agents (Harness, Orchestrator, Agentic Framework – das Wording ist hier noch nicht wirklich definiert) ist kaum zu unterschätzen. Ein Leak des Quellcodes von Claude Code machte das deutlich. Man möchte meinen, ein fortgeschrittenes Frontier-Modell wäre in der Lage die Stimmung des Nutzers zu erkennen, und doch haben die Entwickler von Anthropic einen Regulären Ausdruck eingebaut, der nach typischer Frustration im Prompt sucht:
/\b(wtf|shit|fuck|horrible|awful|terrible)\b/i
Das verdeutlicht, dass das LLM alleine nicht ausreicht für wirklich gute Ergebnisse. Erst das sinnvolle Zusammenspiel der verschiedenen Komponenten ermöglicht es, auch mit vergleichsweise einfacher Hardware sinnvolle Aufgaben erledigen zu lassen.
Das lokale KI-Ökosystem
| Beschreibung bzw. Beispiele | |
|---|---|
| LLM | Das eigentliche Modell, etwa Opus 5 (Cloud) oder Qwen3.8 27b (Local) |
| Agent | Schleife: Fragt das LLM an, interpretiert die Antwort und nutzt Tools. Woraus wieder eine neue Anfrage entsteht. |
| Router | Ein Agent kann über einen Router verschiedene LLM ansprechen, etwa kleine Modelle für einfache Aufgaben nutzen. |
| Tools | integrierte Websuche, Zugriff auf lokale Dateien, etc. |
| MCP | aktuelle Daten abrufen, Browser-Steuerung |
| Skills | Vordefinierte Anleitungen für wiederkehrende Aufgaben, die dem Agenten als zusätzlicher Kontext mitgegeben werden |
Unser eingangs gezeigter Stack aus Modell, Inferenz und Client ist in Wirklichkeit deutlich komplexer. In den Clients der großen Anbieter stecken sehr viel Logik und Intelligenz, die wir auch in unserem lokale KI-System bereitstellen müssen.
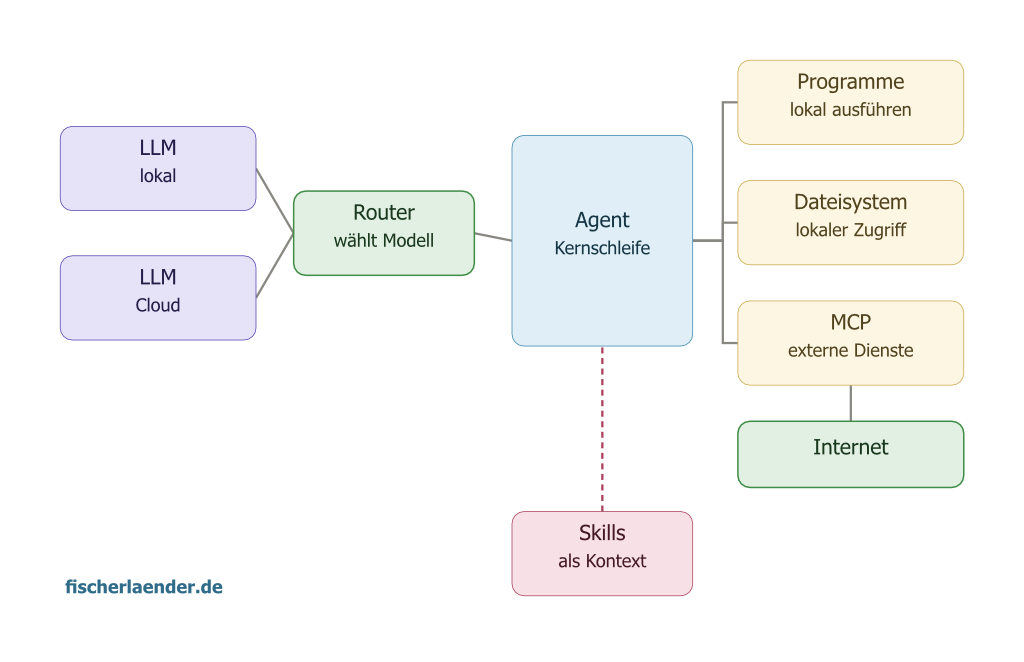
Moderne Clients bieten bereits viele Tools an. Jan beispielsweise benötigt nur wenige Klicks, um dem aktiven Modell eine Websuche freizuschalten (siehe 5-Minuten-Einführung: Einstellungen) oder MCP-Server anzubinden.
Soll unsere lokale KI noch mächtiger werden, benötigen wir einen Agent, der eine Aufgabe selbständig erledigt. Der Agent stellt dazu Fragen an ein LLM, wertet die Antworten aus und führt dann entsprechende Aufgaben durch. Eine typische Frage-Antwort-Schleife könnte so aussehen:
Nutzer: „Erstelle mir ein Programm in Python, um die ersten 50 Fibonacci-Zahlen zu berechnen.“
Agent: gibt diese Anfrage ans LLM
LLM: sendet Programmcode als Text zurück
Agent: speichert den Programmcode als lokale Datei, führt das Programm aus und sendet die Fehlermeldung des Programms ans LLM
LLM: sieht die Fehlermeldung, überarbeitet das Programm und sendet die neue Version zurück
Agent: führt das Programm erneut aus und sendet die Ausgabe wieder ans LLM
LLM: erkennt den fehlerfreien Lauf und sendet diese Erkenntnis an den Agent
Agent: beendet die Aufgabe
In wenigen Schritten zum lokalen Agentic Setup
Wie lässt sich ein solches System am einfachsten nachbauen? Einen sehr einfachen Einstieg bietet goose (öffnet in neuem Tab) an. Es lässt sich auf den üblichen Betriebssystemen problemlos installieren und ist ein direkter Ersatz für z.B. Claude Code. Die wichtigsten Tools sind bereits mit dabei, viele weitere lassen sich installieren.